Ataccama Export: Welches Tool wann?
Jeder, der schon einmal Stammdaten in Ataccama ONE aufbereitet hat, kennt diesen Moment: Das Data-Quality-Modell steht, die Golden Records sind gematcht – und jetzt steht das Konsumenten-Team in der Tür und fragt: „Wie kommen wir an die Daten?“
Genau an diesem Punkt entscheidet sich, ob Ihre Architektur performant und wartbar bleibt oder ob Sie sich ein administratives Monster bauen. Ataccama gibt uns dafür zwei primäre Werkzeuge an die Hand: Data Sets und Export Operations.
Dabei verfolgen beide Ansätze das Ziel, konsolidierte Stammdaten bereitzustellen. Wer jedoch im Ataccama ONE Desktop entwickelt und die Daten später im Ataccama Portal bereitstellt, merkt schnell, wie unterschiedlich ihre Architektur tickt.
Warum reicht nicht einfach ein Werkzeug für alles?
Stellen Sie sich zwei typische Anwendungsfälle aus der Praxis vor:
- Das Live-Dashboard für Fachanwender: Das Vertriebsteam braucht im ONE Portal eine schnelle, direkte Sicht auf aufbereitete Kundensegmente, um Ad-hoc-Analysen zu fahren.
- Der nächtliche ERP-Batch: Das Finanzsystem benötigt jeden Sonntagabend 2 Millionen Stammdatensätze als CSV. Das Ziel-ERP erwartet allerdings spezifische Feldnamen (
KUNDEN_NRstattMDM_PARTY_ID) und erfordert vor dem Export eine Adressvalidierung gegen eine externe Post-Datenbank (Third-Party Service), um unzustellbare Post zu vermeiden.
Wenn Sie versuchen, Fall 2 über ein einfaches Data Set abzubilden, geraten Sie schnell an Performance‑, Transformations- und Schnittstellengrenzen. Versuchen Sie hingegen, Fall 1 mit einer Export Operation zu lösen, erzeugen Sie unnötigen Entwicklungsaufwand für einen einfachen Read-Access.
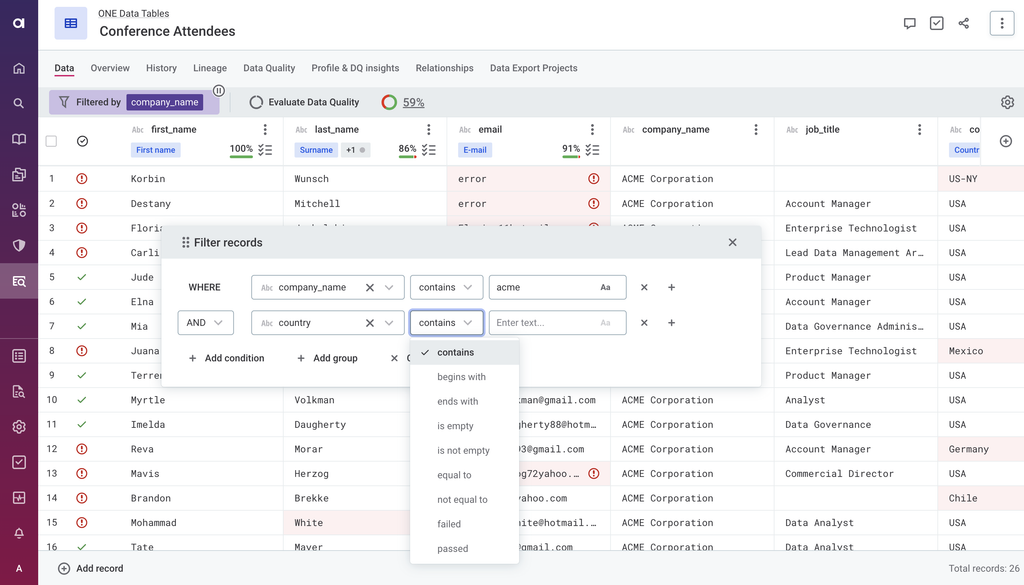
1. Data Sets: Der schnelle Read-Only-View
Ein Data Set ist im Prinzip eine deklarative Abstraktionsschicht direkt auf das MDM-Modell.
Der Konfigurationsweg im ONE Desktop
Die Einrichtung ist für Entwickler nämlich extrem schlank: Im ONE Desktop wählen Sie die benötigten Entitäten und Attribute aus und Ataccama generiert automatisch die passenden SQL-Abfragen und Joins auf Basis des logischen Datenmodells. Sobald das Data Set deployed ist, steht es den Anwendern direkt im ONE Portal zur Verfügung.
- Warum man es liebt: Zero Orchestration Overhead. Es werden keine Export-Prozesse, Workflows oder Scheduler benötigt. Ändert sich ein Datensatz im MDM, sieht der Nutzer im Portal sofort den aktuellen Stand.
- Wo es wehtut: Die Feldnamen sind starr an das Modell gekoppelt. Zielsysteme müssen sich an die Ataccama-Nomenklatur anpassen. Zudem ist bei manuellen SQL Overrides Vorsicht geboten: Wird später ein Feld im Modell umbenannt, schlägt die Server-Validierung beim Deployment fehl.
2. Export Operations: Der Werkzeugkasten für heterogene Quellen
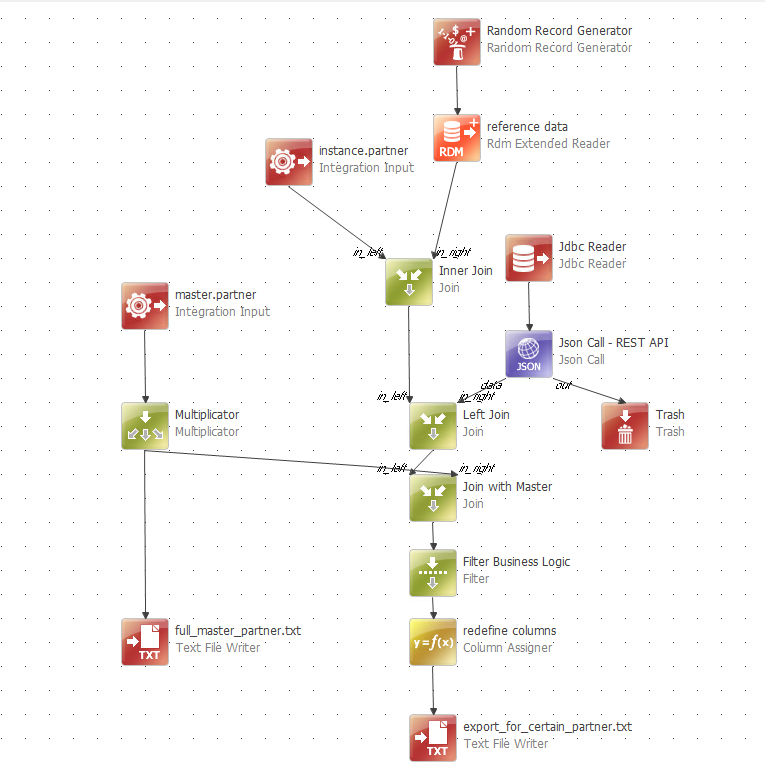
Wenn Sie hingegen Daten transformieren, Quell- und Master-Ebenen kombinieren oder über Drittsysteme validieren müssen, konfigurieren Sie im ONE Desktop eine Export Operation.
Das Multi-Source-Feature im ONE Desktop
Das mächtigste Feature von Export Operations ist die Flexibilität bei den Datenquellen. Sie sind nicht auf die reine MDM-Entität beschränkt, sondern können in einem Prozess:
- Master & Instance Layer kombinieren: Konsolidierte Master-Daten (Golden Records) gezielt mit den dazugehörigen Quell-Einträgen aus dem Instance Layer (z. B. ursprüngliche Quellsystem-IDs, Ladedaten) verknüpfen.
- Third-Party Services & REST APIs nutzen: Daten über Komponenten wie einen Json Call – REST API direkt während des Exportlaufs gegen externe Prüfdienste (z. B. Post-Services) validieren.
- Referenzdaten (RDM) & Datenbanken: Über RDM Extended Reader oder JDBC Reader zusätzliche Lookup-Tabellen einbinden.
- Flexible Ausgabeziele: Ergebnisse über Column Assigner umbenennen und in verschiedene Formate oder Dateien exportieren.
REST-API-Bereitstellung via Instance Layer
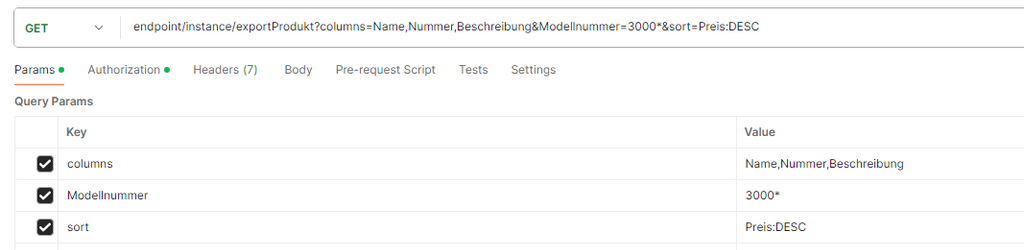
Ein weiterer entscheidender Vorteil: Das Ergebnis einer Export Operation kann über einen Full-Load-Prozess als neue Entität im Instance Layer zurück in das MDM geladen werden.
Dadurch stehen die exportierten und aufbereiteten Daten automatisch über die standardisierte Ataccama REST API bereit – inklusive Query-Parametern wie columns, filter und sort:
Der Haken im Entwickler-Alltag
Es ist kein „Click & Forget“. Für eine funktionierende Export Operation müssen im ONE Desktop der Export-Plan, die Workflows und der Load-Job aufgebaut sowie die Zeitsteuerung im Scheduler eingerichtet werden. Zudem gilt: Ändert ein Kollege ein Entity-Modell, werden bestehende Mappings im Export-Prozess nicht automatisch nachgeführt.
Entscheidungshilfe: Wann nutzt man was?
Für die nächste Schnittstellenplanung im ONE Desktop hilft diese einfache Faustregel:
| Anforderung | Data Set | Export Operation |
| Bereitstellung für Endnutzer | ONE Portal / UI | Files / DB-Tabellen / REST API via Instance Layer |
| Entwicklungsaufwand | Minimal (Minuten) | Mittel bis hoch (Prozesse & Workflows) |
| Datenaktualität | Live / Realtime | Batch-gesteuert via Scheduler |
| Quellen-Flexibilität | Nur verknüpfte MDM-Entitäten | MDM + Files + RDM + REST APIs |
| Feldbezeichnungen (Aliases) | Starr am Modell | Frei anpassbar |
Fazit: Prototyping mit Data Sets, Scaling mit Export Operations
Data Sets bieten die direkte Abkürzung für schnelle Sichten und Ad-hoc-Analysen im ONE Portal. Export Operations hingegen sind das zentrale Werkzeug im ONE Desktop für komplexe System-Integrationen, Dateiexporte und Validierungen gegen externe Drittsysteme wie Post-Services.
Pro-Tipp aus der Praxis: Nutzen Sie Data Sets als schlanken Prototyp! Bevor Sie im ONE Desktop den deutlich höheren Entwicklungsaufwand für komplexe Export-Pläne, Mappings und Workflows investieren, können Sie die Grundlogik zuerst über ein Data Set testen. Sobald Sie im ONE Portal bestätigt haben, dass Datenstrukturen und Qualitäten im Modell grundsätzlich passen, nutzen Sie diese Erkenntnisse als Orientierung für die anschließende manuelle Entwicklung Ihrer Export Operation.
Wer beide Mechanismen an der richtigen Stelle kombiniert, spart nicht nur Entwicklungszeit, sondern hält die Ataccama-Architektur langfristig wartbar und performant.